Multiregion Results Agent — Sistema de Adquisición de 59 Fuentes
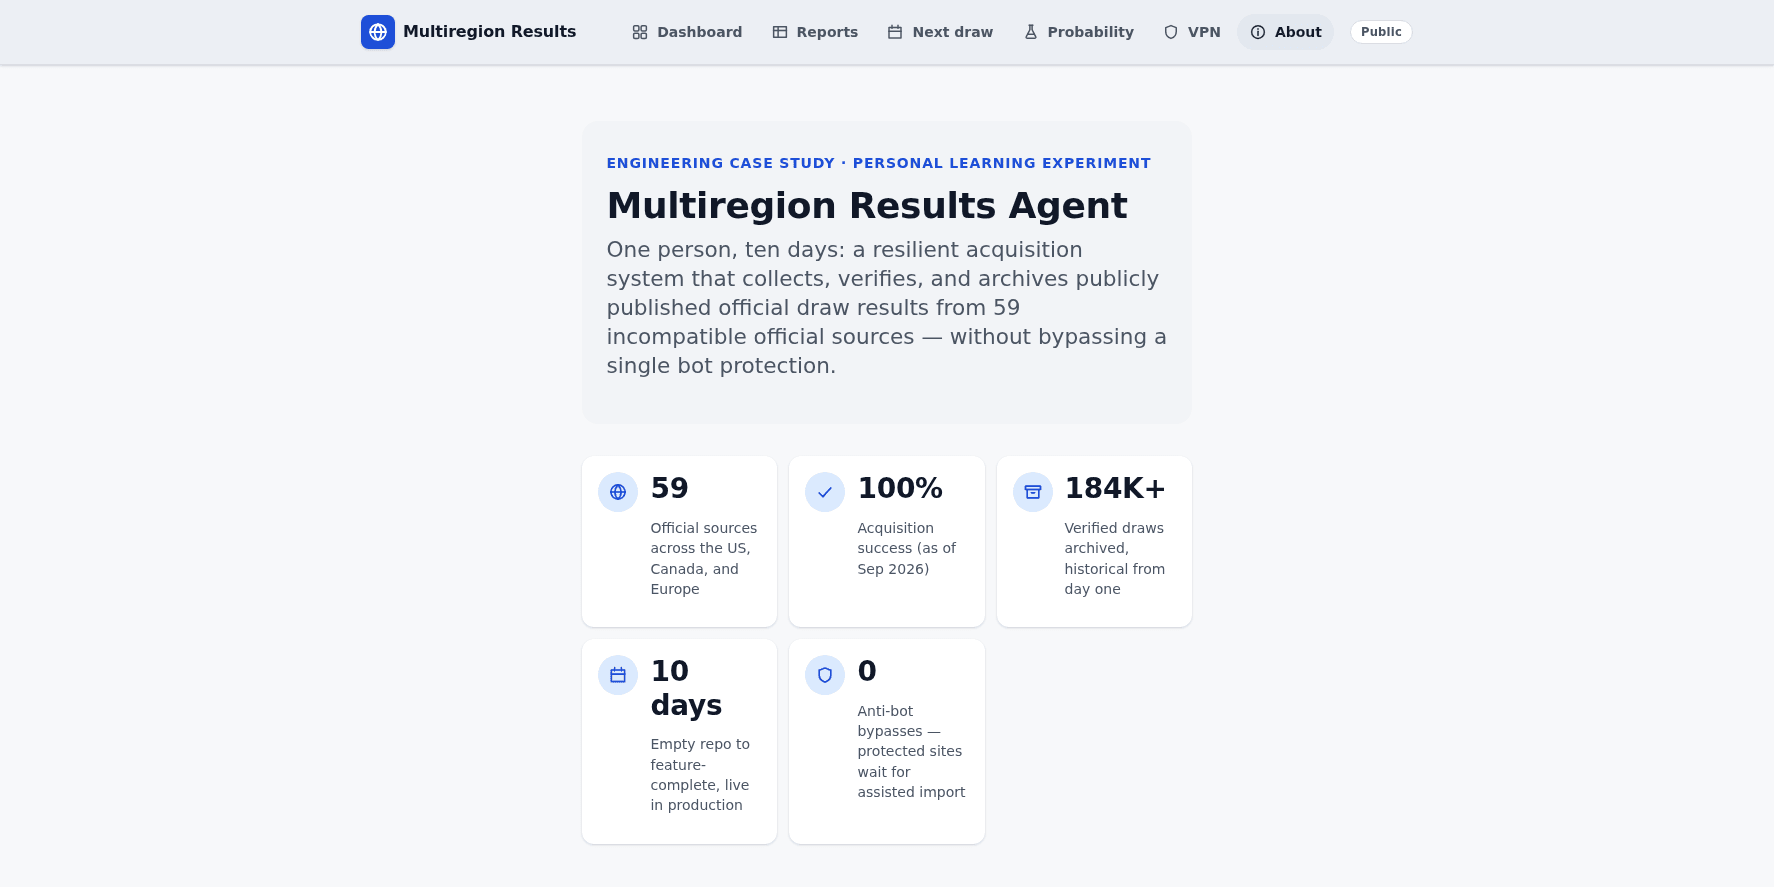
Una persona, diez días: un sistema de adquisición resiliente que recopila, valida y archiva resultados oficiales de sorteos desde 59 fuentes incompatibles — sin resolver un solo CAPTCHA ni usar evasión sigilosa
Cincuenta y nueve publicadores oficiales en tres regiones, sin dos iguales: APIs JSON, tablas renderizadas en servidor, aplicaciones JavaScript, documentos PDF, páginas protegidas contra bots y endpoints con restricciones geográficas. No existe un feed común y ningún agregador tiene cobertura completa. La parte difícil no es almacenar los datos — es adquirirlos de todos ellos, de forma confiable, respetuosa y sostenible.
Multiregion Results Agent es un caso de estudio de ingeniería de un solo autor: un motor de adquisición que cumple las normas — respeta robots.txt, presupuesta solicitudes por host con jitter, guarda cada página cruda antes de parsear y nunca resuelve un CAPTCHA ni usa evasión sigilosa: las fuentes protegidas esperan una importación manual asistida. Todo aterriza en un archivo local de PostgreSQL: un panel de búsqueda, páginas por jurisdicción, reportes por rango de fechas con exportación Excel en streaming, calendarios derivados de próximos sorteos y un laboratorio de probabilidad honesto.
El problema
Los resultados oficiales de sorteos están dispersos en 59 publicadores incompatibles en Estados Unidos, Canadá y Europa. Algunos exponen APIs JSON; otros sirven HTML renderizado en servidor; otros son aplicaciones JavaScript que requieren un navegador; otros publican PDFs; otros están detrás de protección anti-bot o restricciones geográficas. No hay un feed común y los agregadores no tienen cobertura completa.
El problema de ingeniería no es el almacenamiento — es la adquisición. Obtener los 59 sin resolver un solo CAPTCHA ni usar evasión sigilosa, mantenerse dentro de robots.txt y de los presupuestos de cortesía por host, mantener accesibles las páginas con restricciones geográficas y no perder nada: cada respuesta cruda debe archivarse antes de parsear, para que una fuente nunca se pierda, incluso si su parser aún no existe.
El enfoque
Un pipeline de adquisición de tres niveles construido alrededor del cumplimiento en lugar de la evasión:
- Nivel directo — httpx con perfiles de encabezados de navegador para fuentes HTML planas y APIs JSON.
- Nivel navegador — Chromium en contenedor vía Playwright para páginas renderizadas con JavaScript, solo cuando el nivel directo falla con 403/406/5xx/timeout.
- Nivel API — endpoints JSON de primera clase (p. ej. Mega Millions).
Alrededor de los niveles, la capa de disciplina: verificación de robots.txt, retraso ≥2s por host con jitter, una solicitud concurrente por host, backoff exponencial y guardado de cada página cruda antes de parsear. La salida geo-consciente a través de una VPN controlada con pines de salida por jurisdicción desbloquea páginas oficiales restringidas por región. Las fuentes se clasifican como api | html | js | restricted; los sitios restringidos nunca se obtienen automáticamente — van a una cola de importación asistida (scripts/import_manual.py, POST /api/import).
Una flota de parsers por fuente con cobertura probada por fixtures normaliza cada formato hacia PostgreSQL 16 (jurisdictions · draws · raw_pages · logs). Las fuentes HTML simples se agregan mediante backend/sources.json con selectores CSS — sin necesidad de Python. La web se consulta una sola vez en el momento de la adquisición y nunca en el momento de la lectura.
Encima corre el panel de Next.js: páginas por jurisdicción, reportes por rango de fechas, exportación XLSX en streaming, calendarios derivados de sorteos y un laboratorio de probabilidad que evalúa 8 estrategias con historial contra una línea base uniforme mediante backtests walk-forward, puntajes de habilidad Brier/log-loss, verificación de calibración y pruebas de equidad χ². La seguridad es fail-closed: sin cuentas, enlaces secretos imposibles de adivinar en tres roles (admin, acceso completo, solo lectura), verificación de tokens en tiempo constante, limitación por IP y restricciones de solo lectura aplicadas en el servidor.
El resultado
En vivo desde septiembre de 2026: 59 fuentes habilitadas → 59 ok, 0 fallidas, 0 restringidas; cada fuente produce sorteos parseados; 184K+ sorteos archivados con una tasa de éxito de adquisición del 100.0%. Todo el sistema — del primer commit a funcionalidad completa — fue construido por una persona en diez días (2026-09-04 → 2026-09-14).
La construcción también pasó por una revisión hostil de su propia superficie: una evaluación de seguridad contra el prototipo en vivo produjo 21 hallazgos que se reducen a 16 problemas distintos, dos de ellos críticos — una CVE de omisión de middleware del framework y una ruta de autorización fail-open. El plan de remediación está escrito, las correcciones están confirmadas y desplegadas, el framework se actualizó de 15.1.6 a 15.2.3 en la misma pasada y la omisión ya no se reproduce. Reportar lo que encontró una lectura hostil de mi propio trabajo importa más que el número de hallazgos.
El laboratorio de probabilidad dice con claridad lo que muestran las matemáticas: en juegos profundos y justos, ninguna estrategia supera al azar. Esa honestidad es el punto del experimento — la herramienta reporta una distribución, nunca una predicción, y el modelo de acceso (enlaces secretos, sin base de datos de usuarios) es en sí mismo un ejercicio de seguridad. No tiene compromiso de disponibilidad y no ofrece asesoría financiera, estadística ni de apuestas; nada coloca, valora o facilita una apuesta.
Visitar el proyecto
El sitio público en prototype.datawork.top está abierto y explica la construcción. Un enlace de demostración de solo lectura — rotable y forzado en el servidor — se entrega a pedido; solicite uno vigente. Esto es un prototipo de ingeniería, no un producto: sin compromiso de disponibilidad, sin cuentas y sin asesoría financiera ni de apuestas.
Visitar el proyectoConclusión clave
La confiabilidad entre 59 fuentes incompatibles no es un problema de parseo — es un problema de cumplimiento. Respete robots.txt, los rate limits y las protecciones anti-bot, y los casos difíciles dejan de ser difíciles: se convierten en una cola honesta de importación asistida en lugar de un juego del gato y el ratón.
¿Listo para construir su plataforma?
Una llamada de 30 minutos para ver si somos el aliado correcto. Sin discurso de venta. Sin presión. Solo una conversación sobre lo que necesita construir.
La mayoría de los proyectos inicia con un diagnóstico de arquitectura acotado: de $5,000 a $12,000, de 1 a 3 semanas. Construcción de plataformas a precio fijo: de $20,000 a $80,000, con control por hitos, 50% de depósito. CTO fraccional: de $6,000 a $10,000 por mes, mínimo 90 días.